Le 20 août 2026, trois jours après la panne, le directeur technique de GitHub, Vlad Fedorov, publie un billet qui commence par un aveu : si vous essayiez de livrer ce jour-là, « we let you down ». Le rapport de disponibilité d'août détaille, lui, cinq incidents du mois. Ces deux textes permettent de relire la panne du 17 août avec un œil de testeur : quel mécanisme a cédé, et quel test l'aurait sollicité ?
Précision d'emblée : on ne sait pas ce que GitHub testait avant. Ce qui suit dit ce qu'un test de charge ou de résilience pourrait chercher, pas ce qu'il aurait forcément trouvé.
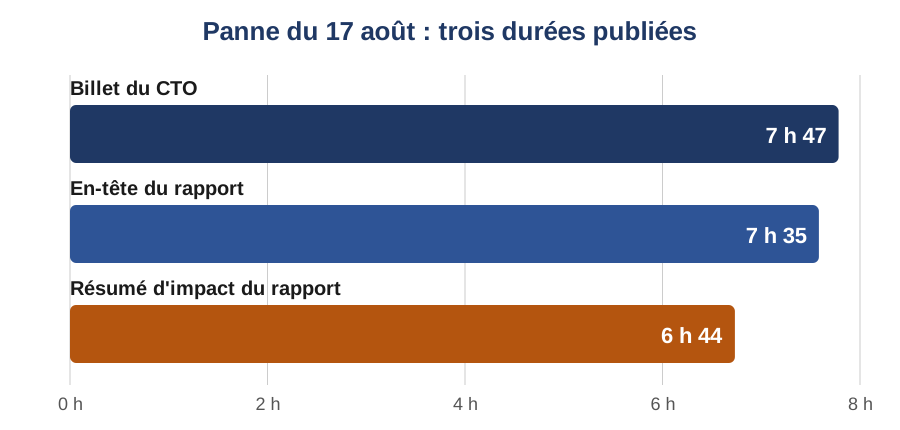
Deux textes, trois durées
Le billet du CTO parle de 7 heures et 47 minutes. Le rapport donne 7 heures et 35 minutes dans son en-tête (début à 13 h 40 UTC), et « environ 6 heures 44 minutes » dans son résumé d'impact. Developpez, qui relaie le billet, indique un début à 15 h 40 et une fin à 23 h 15 en heure de Paris, soit 7 h 35 d'écart, alors que son titre annonce 7 h 47.
Les taux d'erreur ne sont pas plus faciles à comparer. Le rapport donne 56,07 % des requêtes d'entrée en échec ou lentes au plus fort de la panne, mesurées en périphérie. Developpez cite environ 20 % d'erreurs pour le trafic web et API et 50 % pour les téléchargements bruts de dépôts. Programmez situe jusqu'à 50 % d'erreurs sur les accès aux dépôts entre 14 h 04 et 14 h 24. Ce sont trois définitions différentes (échec seul, échec ou lenteur, périmètre variable). Avant un test, la première décision à prendre est celle-là : qu'appelle-t-on erreur ?
La cascade, d'après le rapport
Le billet du CTO reste général : un composant d'infrastructure critique de son centre de données « Central US » n'a pas suivi la montée du trafic. Le rapport est plus précis. Un sidecar du maillage de services a atteint sa limite de concurrence sans monter en charge. Plusieurs nœuds de load balancers ont ensuite épuisé leurs limites de flux réseau, ce qui a dégradé le chemin d'authentification commun à tous les services passant par ce centre de données. Un bug de réessai côté client a amplifié le trafic vers un point d'authentification interne et ralenti la reprise du service de jetons de Copilot.
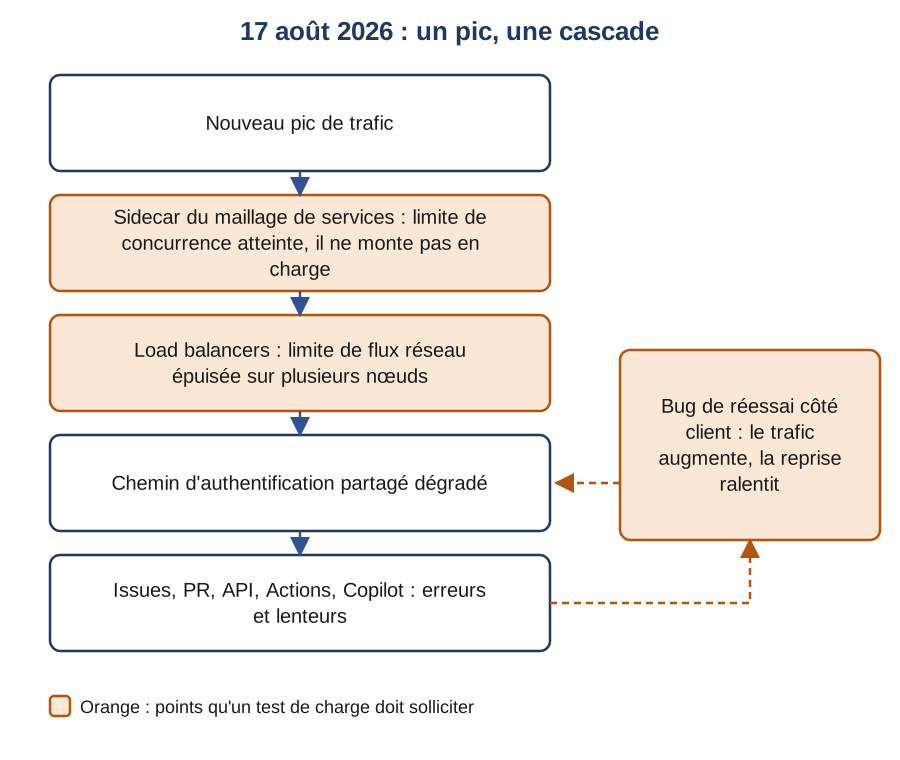
Les deux textes de GitHub ne nomment pas VS Code. Le billet évoque « a client-side retry loop » sur certains services Copilot, le rapport « a latent client retry bug ». L'idée d'une tempête de reconnexions de VS Code vient de Developpez, qui l'attribue à GitHub sans citer de passage. Le billet renvoie à une analyse complète des causes, avec chronologie technique, qui n'a pas été lue ici et pourrait le dire : l'affirmation reste donc non vérifiée.
Autre détail du rapport : « Retrying often worked ». Le service n'était pas à l'arrêt, il était instable, ce qui est un cas plus difficile à reproduire qu'une panne franche.
Le même motif sur trois incidents
Le rapport décrit aussi deux incidents de GitHub Actions, avec des traits voisins.
| Date | Déclencheur | Ce qui a amplifié |
|---|---|---|
| 6 août | Un déploiement de routine réduit brièvement la capacité d'un site (remplacement de pods) ; le trafic qui se reporte fait dépasser leur limite aux autres sites | Les sidecars subissent saturation du processeur et redémarrages par manque de mémoire ; des exécuteurs reçoivent des tâches révoquées et les réessaient en boucle |
| 17 août | Nouveau pic de trafic dans un centre de données | Sidecar qui ne monte pas en charge, limites de flux des load balancers, réessais clients |
| 26 août | Rafale d'événements à un pic quotidien, base partagée déjà proche de sa limite | Pas de coupe-circuit automatique ; limitations d'entrée posées « légèrement trop hautes », reprise lente et manuelle |
Le fil commun, le billet du CTO le résume lui-même pour les pannes des 6 et 17 août : aucune n'a été causée par un changement de code ou de configuration, ce sont des « capacity failures at their core ». Il ajoute que le nombre de commits mensuels est passé de 1,4 à 2,9 milliards depuis avril. Un modèle de capacité construit au printemps pouvait donc être périmé en août.
Six tests à écrire
Le tableau ci-dessous associe chaque mécanisme observé à un test, et rappelle ce que GitHub dit avoir décidé.
| Mécanisme observé | Test à écrire | Décision de GitHub |
|---|---|---|
| Autoscaling piloté par le service hôte, pas par son sidecar | Montée en charge au-delà du pic observé, avec relevé de la concurrence à chaque saut (sidecar, load balancer), pas seulement du service final | Politiques d'autoscaling qui tiennent compte de la capacité du sidecar ; audit des limites du maillage |
| Limites de flux réseau des load balancers | Même montée en charge, avec suivi de la table de flux et des nœuds saturés | Meilleure supervision de la capacité des load balancers |
| Réessais clients qui amplifient | Injecter un taux d'échec sur un point d'authentification et mesurer le rapport entre requêtes envoyées et requêtes utiles | Limites, budgets de réessai et délais variables cohérents entre services |
| Reprise freinée par le trafic de retour | Retirer la panne sous charge et mesurer le temps de retour à la normale, avec et sans remontée progressive du trafic | Aucune décision listée ; pendant l'incident, le trafic a été remonté progressivement |
| Marge perdue pendant un déploiement (6 août) | Déployer pendant un pic, avec une exigence : jamais sous la capacité nécessaire pendant le déploiement | Éviter les réductions de capacité pendant les déploiements |
| Protection posée à la main (26 août) | Pousser la base vers sa limite et vérifier qu'un coupe-circuit se déclenche, et à quel niveau | Coupe-circuit automatique sur la charge entrante |
À notre avis, le test de réessais est le plus instructif : il révèle un comportement de client que ni les tests fonctionnels ni la charge nominale n'exercent. Le facteur d'amplification (requêtes envoyées sur requêtes utiles) est une proposition de métrique de notre part, pas un chiffre publié par GitHub.
Ce que ces tests ne garantissent pas : qu'ils auraient détecté la limite de concurrence du sidecar, qui dépend de la fidélité du banc d'essai à la production. Le rapport qualifie d'ailleurs l'une de ses mesures (le déplacement de 33 % des tâches hors d'un cluster contraint) de « near-term containment », pas de solution durable. Les correctifs listés pour le 17 août sont des intentions. Le rapport affirme, en termes généraux, avoir amélioré la supervision de la capacité et les règles de réessai, sans dire lesquels des correctifs listés sont en place.
Publié par Philippe Naveau
Sources
- The August 17 outage, and the work ahead (Vlad Fedorov, blog GitHub, 20 août 2026), lu le
- GitHub availability report: August 2026 (blog GitHub), lu le
- Panne mondiale de GitHub : la journée catastrophe du 17 août (Programmez), lu le
- Le 17 août, alors que le trafic atteignait un nouveau pic, GitHub a connu une panne de 7 heures et 47 minutes (Developpez, 22 août 2026), lu le
- GitHub cite un dysfonctionnement de l'autoscaling et une tempête de tentatives de reconnexion dans VS Code (Developpez, 20 août 2026), lu le