Un test de robustesse vérifie qu'une panne que vous avez prévue ne casse pas l'application. Le chaos engineering fait l'inverse : il cherche les pannes auxquelles personne n'a pensé. Les deux se complètent, et le second réutilise presque tout l'outillage d'une campagne de performance : un état stable mesuré, une supervision fine, des tirs reproductibles.
Ce que c'est, et ce que ce n'est pas
Le site principlesofchaos.org définit le chaos engineering comme la discipline qui consiste à expérimenter sur un système pour avoir confiance dans sa capacité à résister à des conditions turbulentes en production. Il détaille quatre étapes : définir l'état stable comme une sortie mesurable, supposer qu'il se maintient, introduire des événements du monde réel (un serveur qui tombe, un disque défaillant), puis chercher un écart d'état stable. Le site ajoute des principes avancés : bâtir l'hypothèse sur le comportement de l'état stable, varier les événements, expérimenter en production, automatiser et limiter le rayon d'impact.
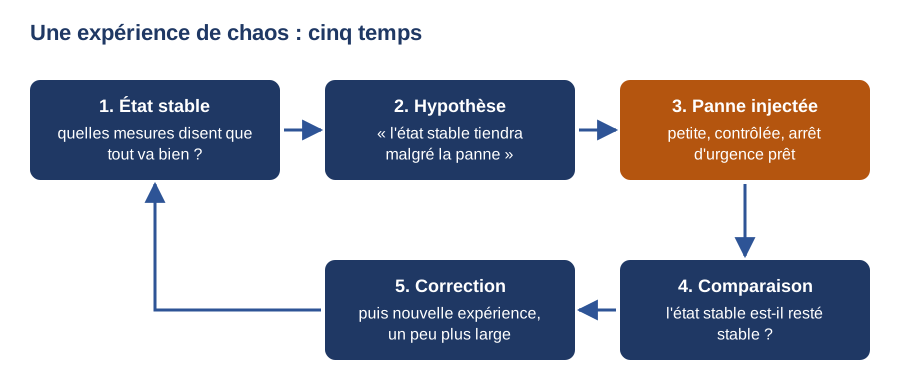
Ce n'est donc pas du sabotage. Une expérience a une hypothèse, une mesure, un périmètre et une fin. Sans mesure préalable de l'état stable, on provoque une panne et on regarde, ce qui ne prouve rien.
Chaos et ISTQB
Le syllabus de performance de l'ISTQB (2018) ne mentionne ni la résilience ni le chaos (recherche textuelle ; le glossaire en ligne n'a pas été consulté). Microsoft, de son côté, présente Azure Chaos Studio comme un service d'expériences d'injection de pannes contrôlées, distinct des tests de charge. Rangez donc le chaos à côté des tests de performance, pas dedans, et écrivez-le dans votre plan de tests.
La différence avec le test de robustesse
Le test de robustesse, tel que ce guide le décrit, rejoue un scénario de panne choisi à l'avance, avec des exigences précises : arrêter un serveur sur deux et vérifier que l'autre tient. Le chaos varie les pannes, et ce qu'on y cherche, c'est l'écart qu'on n'attendait pas. Le premier valide ce qu'on sait, le second explore. À notre avis, un projet qui n'a jamais joué de test de robustesse n'a rien à gagner à commencer par le chaos.
Ce que Netflix a réellement publié
Le chaos engineering reste associé à Netflix, et les légendes qui l'entourent méritent un tri.
- Chaos Monkey termine des machines virtuelles et des conteneurs au hasard en production. Son dépôt n'est pas archivé : la dernière version lue, la 2.1.3, date du 6 janvier 2025, et le README demande des applications gérées avec Spinnaker.
- La « Simian Army », l'ensemble des « singes », a un dépôt archivé depuis décembre 2018, dont le README dit que le projet n'est plus activement maintenu. Selon Gremlin, Latency Monkey n'a jamais été publié et Doctor Monkey n'est pas ouvert.
- Pour la région : l'article publié en 2016 par l'équipe de Netflix dans IEEE Software explique que l'hypothèse testée est qu'une bascule de trafic vers une région saine a un impact minimal sur le nombre de démarrages de lecture par seconde. Netflix y précise qu'il ne met pas vraiment une région AWS hors ligne, faute de capacité, mais redirige les requêtes comme si elle l'était, lors d'exercices mensuels. L'affirmation « Netflix peut perdre une région entière sans interruption de service » est donc plus forte que ce que Netflix écrit.
Quelles pannes injecter, avec quoi
Les exemples que l'on cite le plus, et ce que les documentations des outils disent lire :
| Panne | Outils dont la documentation la décrit | Nuance |
|---|---|---|
| Latence sur un appel (+500 ms) | Toxiproxy, Chaos Mesh, LitmusChaos, Gremlin, AWS FIS | Toxiproxy agit sur une connexion TCP qui passe par lui ; les autres agissent sur le réseau d'un pod ou d'une machine |
| Disque rempli à 95 % | AWS FIS (95 % par défaut), Gremlin, LitmusChaos | Litmus remplit le stockage éphémère du pod en pourcentage de sa limite : elle doit être définie |
| Horloge décalée | Chaos Mesh (TimeChaos), Gremlin | Chaos Mesh ne touche que le processus principal du conteneur et ses enfants |
| 10 % de requêtes en échec | Toxiproxy, Chaos Mesh | Ces outils parlent de connexions et de paquets, pas de requêtes HTTP : pour un taux précis d'erreurs HTTP, il faut un proxy applicatif ou une fonction de la plateforme |
Les outils ont aussi des statuts très différents. Au 5 novembre 2026 : LitmusChaos et Chaos Mesh sont des projets incubating de la CNCF, avec des versions publiées en octobre ; Toxiproxy et Chaos Toolkit sont des projets libres maintenus ; Gremlin est une plateforme commerciale ; AWS Fault Injection Service est un service managé AWS ; Azure Chaos Studio est en partie en préversion publique, sans SLA ni usage de production recommandé.
Les garde-fous, avant toute expérience
Le principe de limitation du rayon d'impact est dans les principes du site. En pratique, avant même de penser à la production :
- une supervision complète est en place, qui montre l'état stable ;
- le retour arrière a été testé, avec un arrêt d'urgence que tout le monde sait déclencher ;
- l'astreinte est prévenue et la fenêtre de tir exclut les heures de pointe ;
- la première expérience est petite, dans un environnement de préproduction : redémarrer un seul serveur.
Ces garde-fous relèvent de la pratique, pas d'une norme. Ajustez-les à votre organisation, mais ne sautez pas l'arrêt d'urgence.
Dans une campagne de performance
Une approche raisonnable consiste à jouer d'abord les tests de charge nominale et de robustesse, puis à reprendre le même tir en y ajoutant une panne : une latence sur un service en aval pendant le plateau, par exemple. Les temps de réponse et les erreurs dans la supervision disent si l'état stable a tenu. Si la réponse est non, la correction commence là.
Rédigé avec l’aide d’une IA, relu et validé par Philippe Naveau.
Sources
- Principles of Chaos Engineering, lu le
- Chaos Engineering (Basiri et al., IEEE Software, 2016), préversion arXiv, lu le
- Netflix/chaosmonkey (dépôt GitHub et README), lu le
- Netflix/SimianArmy (dépôt GitHub archivé et README), lu le
- The Simian Army (Gremlin), lu le
- Chaos Mesh, projet CNCF, lu le
- LitmusChaos, projet CNCF, lu le
- Toxiproxy (Shopify), dépôt GitHub, lu le
- Chaos Toolkit, lu le
- Azure Chaos Studio overview (Microsoft Learn), lu le
- AWS Fault Injection Service, what is it, lu le
- Chaos Mesh : simuler le chaos réseau sur Kubernetes, lu le
- Chaos Mesh : simuler le chaos horloge sur Kubernetes, lu le
- LitmusChaos : expérience disk-fill, lu le
- ISTQB CT-PT, syllabus Performance Testing 2018, lu le