Presque chaque éditeur d'outil de charge annonce aujourd'hui une fonction d'IA. Les pages qui les décrivent racontent ce que la fonction fait, rarement ce qu'elle vaut. Cette fiche trie ce qui est documenté, à la date du 5 novembre 2026, de ce qui ne l'est pas.
Ce que les pages décrivent
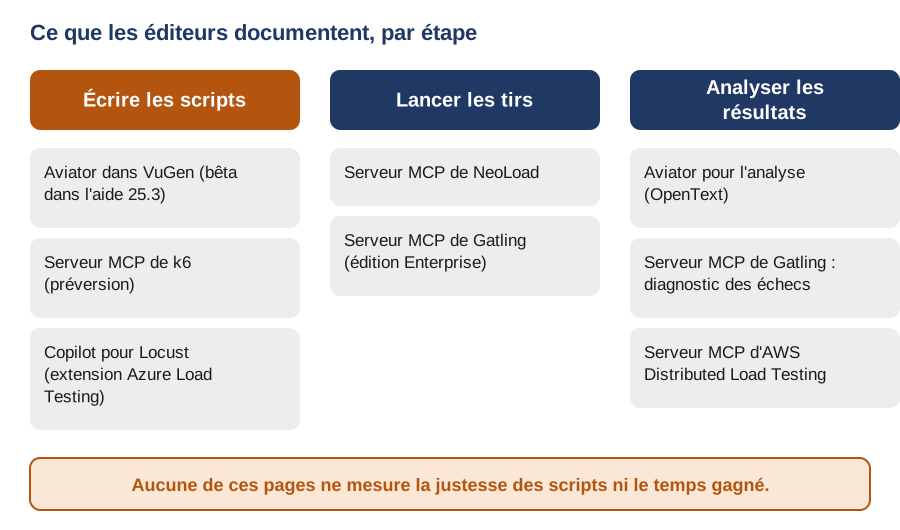
Les éditeurs parlent souvent d'un « serveur MCP » : un composant par lequel un assistant d'IA appelle les actions de l'outil, comme lister des tests ou lancer un tir.
OpenText. L'aide de VuGen 25.3 décrit Aviator pour le scripting : aide sur le protocole, analyse et correction d'erreurs, assistance au code, optimisation et résumé de scripts. L'aide l'annonce en bêta. Les pages produit ajoutent « Ask Aviator » sur une erreur du journal de rejeu, une analyse pilotée par l'IA, et, pour la version 26.1, le scripting par IA et la prise en charge du MCP pour DevWeb, présentés comme généralement disponibles. Un nouveau protocole permet aussi d'écrire des scripts qui testent des services de modèles de langage.
Tricentis. Un billet du 22 juillet 2025 présente le MCP de NeoLoad : un assistant d'IA peut découvrir et gérer des tests et des espaces de travail, lancer des tests, analyser et rapporter. La documentation demande un jeton d'API et Node.js 18 ou plus, et nomme deux assistants testés, Cursor et Claude Desktop. Un piège de vocabulaire : les « MCP actions » des notes de version de NeoLoad 2026.2 servent à tester des serveurs MCP depuis un parcours utilisateur, pas à faire écrire des scripts par une IA.
Gatling. Un serveur MCP local, réservé à l'édition Enterprise, liste les équipes, paquets, tests, emplacements et exécutions, croise les journaux d'exécution et le rapport pour diagnostiquer des échecs, et peut démarrer ou arrêter des exécutions selon le rôle du jeton. Gatling affirme que les données ne quittent pas la machine ; c'est une déclaration de l'éditeur, non vérifiée ici.
Grafana k6. Un serveur MCP (k6 x mcp, commande citée d'après la documentation, non rejouée ici), « en préversion » selon la documentation, écrit des scripts à partir de la documentation et des définitions TypeScript embarquées, les valide, les exécute en local et convertit des tests Playwright en scripts navigateur. La page dit viser à réduire les erreurs d'API inventées : c'est un objectif, pas un résultat mesuré. Elle avertit aussi que le transport HTTP n'a pas d'authentification intégrée et qu'il ne faut pas l'exposer sur un réseau public.
Microsoft. L'extension Visual Studio Code d'Azure Load Testing utilise Copilot pour générer un script Locust à partir d'une collection Postman ou Insomnia ou d'un fichier .http. La page demande de relire les changements proposés avant de les accepter.
AWS. La solution Distributed Load Testing propose un serveur MCP optionnel, adossé à Amazon Bedrock AgentCore Gateway, pour interroger les résultats et les analyser.
ISTQB. Le syllabus « Testing with Generative AI » (CT-GenAI) a une version 1.0 approuvée le 25 juillet 2025 et une mise à jour mineure annoncée le 27 avril 2026. Ses cinq domaines couvrent les bases, l'écriture des invites, la gestion des risques (hallucinations, biais, vie privée, sécurité, énergie, réglementation), les solutions de test à base de modèles de langage et l'adoption en organisation. Il ne traite pas spécifiquement des tests de performance.
Ce que les pages ne démontrent pas
Aucune ne donne de mesure de justesse des scripts produits, ni de gain de temps, ni de taux d'erreur. La page produit de Tricentis avance des affirmations sur l'ancienneté de l'éditeur et le temps gagné, sans mesure à l'appui : elles ne sont pas reprises ici comme des faits. Pour Gatling, la page produit range ailleurs l'analyse de rapport par IA à la feuille de route ; on ne sait pas laquelle des fonctions listées est livrée.
Le sujet des hallucinations est documenté, mais pas pour les tests de charge. Une étude présentée au congrès FSE 2026 (volet industriel) sur la génération de tests unitaires par modèle de langage distingue deux origines des échecs de compilation : un contexte manquant, ou une limite du modèle même avec un contexte suffisant. Elle porte sur des tests unitaires, non sur des scripts de charge, et aucune source spécifique aux scripts de charge n'a été retrouvée. Le rapport DORA 2025, de son côté, associe l'adoption de l'IA à un meilleur débit de livraison et à une moindre stabilité.
Comment s'en servir
Ces conseils relèvent de la pratique, pas d'une source : ils prolongent les étapes du guide.
- Traitez le script généré comme un script enregistré : il n'est pas rejouable en l'état. Vérifiez la corrélation, la variabilisation des données et les temps de réflexion.
- Jouez toujours le tir préliminaire à faible charge avant un vrai tir, avec un script généré encore plus qu'avec un autre.
- Gardez la décision humaine : un diagnostic de l'IA sur un tir est une hypothèse à confirmer dans la supervision.
- N'exposez jamais un serveur MCP sans authentification sur un réseau partagé.
Pour s'en faire une opinion fondée, comparez deux scripts sur un même scénario, l'un enregistré à la main, l'autre généré, et mesurez le temps de mise au point de chacun. Aucune page lue ne l'a fait pour vous.
Rédigé avec l’aide d’une IA, relu et validé par Philippe Naveau.
Sources
- OpenText VuGen : nouveautés de la version 25.3, lu le
- OpenText Professional Performance Engineering (page produit), lu le
- Introducing NeoLoad MCP (Tricentis), lu le
- NeoLoad Web : connecter le serveur MCP (documentation Tricentis), lu le
- NeoLoad, notes de version (MCP actions), lu le
- Gatling MCP server (billet et page produit), lu le
- Grafana k6 : configurer un assistant d'IA (serveur MCP), lu le
- Azure Load Testing : créer et lancer des tests depuis Visual Studio Code, lu le
- Distributed Load Testing on AWS, lu le
- ISTQB Certified Tester, Testing with Generative AI (CT-GenAI), lu le
- Understanding and Mitigating Hallucinations in Industrial LLM-based Unit Test Generation (FSE 2026), lu le
- Annonce du rapport DORA 2025 (Google Cloud), lu le