Le 27 octobre, OpenTelemetry annonce que son langage de transformation, OTTL, passe en version 1. Trois jours plus tard, c'est le tour d'OBI, son instrumentation sans code fondée sur eBPF. Entre les deux, Dynatrace élargit ce qu'il sait ingérer de télémétrie d'applications d'IA, et InfoQ rapporte comment LinkedIn trace un parcours de membre du téléphone jusqu'à la base de données. Quatre textes, une même question pour un testeur de performance : sur quoi peut-on désormais compter, et qu'est-ce qu'il faut encore mesurer soi-même ?
Ce que « stable » veut dire, texte par texte
Le mot ne couvre pas la même chose d'un texte à l'autre.
OBI 1.0 prend des engagements de compatibilité sur la configuration (la version 2, avec son schéma généré), sur les interfaces de déploiement documentées et sur les environnements pris en charge. Pour la télémétrie, l'engagement est plus faible : OBI émet un mélange de données qui suivent des conventions stables et de données dont les conventions évoluent encore, et ces dernières peuvent changer à mesure qu'elles mûrissent. Les métriques d'exécution (Go, Java, .NET, Node.js, Python) restent expérimentales. Le projet décrit sa télémétrie dans un registre de schémas compatible avec Weaver, ce qui permet de voir ce qui change entre deux versions.
OTTL v1, disponible à partir de la version 0.164.0 de opentelemetry-collector-contrib, fige la syntaxe et les fonctions standard pour les traces, les métriques et les journaux : une instruction qui s'analyse sur une version 1.x s'analyse et se comporte de même sur les suivantes. Les fonctions « lambda » restent expérimentales, derrière un indicateur de fonctionnalité, et la prise en charge des profils est à part. Quatorze composants du dépôt acceptent OTTL dans leur configuration, dont l'échantillonnage a posteriori, le filtrage et le routage.
Chez Dynatrace, la frontière passe entre ce qui est disponible (l'instrumentation de OneAgent pour les applications Python qui appellent AWS Bedrock, OpenAI ou Azure OpenAI, ou construites avec LangChain) et ce qui est expérimental : quatorze capteurs supplémentaires, dont Anthropic, Mistral, LiteLLM ou Ollama, pour lesquels l'éditeur écrit que la collecte d'attributs est « best-effort » et que le schéma peut changer sans préavis.
| Texte | Annoncé comme stable ou disponible | Expérimental ou hors garantie |
|---|---|---|
| OBI 1.0 | Configuration v2, interfaces de déploiement documentées | Conventions de télémétrie en évolution, métriques d'exécution |
| OTTL v1 | Syntaxe et fonctions standard (traces, métriques, journaux) | Fonctions lambda, profils |
| Dynatrace | Instrumentation Python pour Bedrock, OpenAI, Azure OpenAI, LangChain | Quatorze capteurs Python expérimentaux |
Un élément de calendrier, dans le texte de Dynatrace : le support d'OpenLLMetry se termine fin janvier, et à partir du 1er février trois voies d'ingestion restent possibles (instrumentation OpenTelemetry, applications OpenInference, OneAgent). OpenInference, selon le même texte, a été donné par Arize au projet OpenTelemetry fin mai 2026 et fusionné mi-juin.
LinkedIn : le standard, plus ses propres choix
Le récit de LinkedIn rappelle qu'une grande plateforme fait ses propres choix au-dessus du standard. Chaque requête garde son identifiant de trace OpenTelemetry, mais un identifiant maison, pageForestId, regroupe les requêtes d'une même page. Les données passent par Kafka et sont stockées dans ClickHouse. L'échantillonnage est coordonné : une même décision s'applique côté client et côté serveur, à l'aide d'un identifiant de membre pseudonymisé, pour éviter qu'un côté soit gardé et l'autre jeté. LinkedIn estime que jusqu'à 90 % du volume de certaines traces côté serveur pourrait relever du débogage. InfoQ en tire que l'approche n'apporte pas une capacité inexistante ailleurs : elle fait d'OpenTelemetry le socle commun entre client et serveur.
Ce qu'aucun des quatre textes ne chiffre
Ni OBI, ni OTTL, ni Dynatrace, ni LinkedIn ne donnent dans ces textes de mesure du surcoût de l'instrumentation en processeur, en mémoire ou en latence. OBI ne cite, dans ses remerciements, que des travaux d'amélioration des performances, sans chiffres, et son conseil de mise à niveau est de comparer la télémétrie dans un déploiement canari avant d'élargir. Le même réflexe, appliqué cette fois au coût, est ce qu'un test de charge permet, à condition de le prévoir.
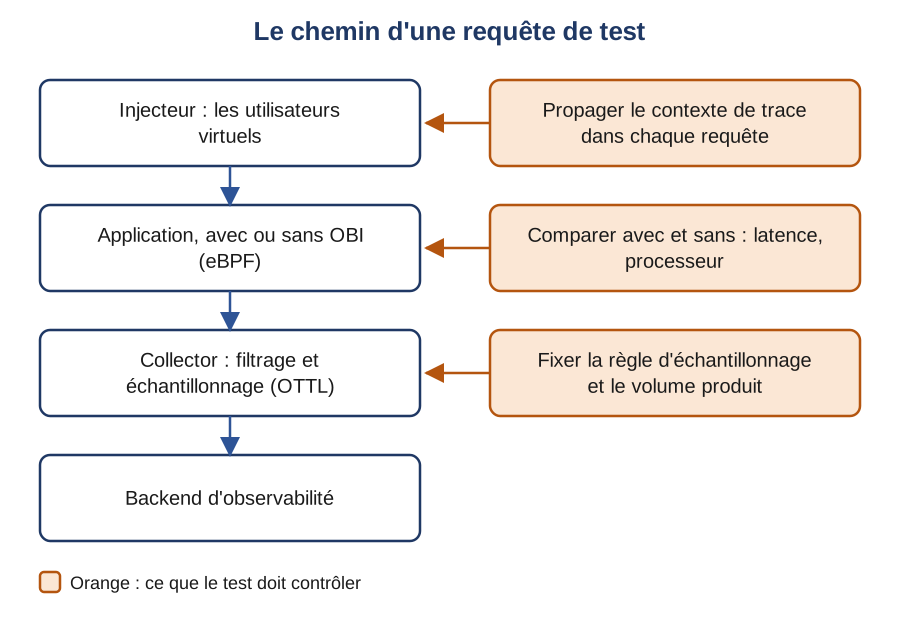
Trois contrôles à ajouter
Comparer avec et sans instrumentation : même scénario, même charge, avec et sans OBI sur le nœud de l'application, et comparaison de la latence et du processeur. Le texte d'OBI promet de ne pas toucher au code source ; il ne dit pas que cela ne coûte rien.
Décider de l'échantillonnage avant le test. Vos utilisateurs virtuels peuvent émettre bien plus de requêtes par minute que des visiteurs réels. Sans règle, le volume de télémétrie du test risque de dépasser celui de la production. OTTL est un moyen de filtrer et d'échantillonner dans le Collector, et deux des témoignages du billet vont dans ce sens : New Relic écarte les métriques d'hôtes que ses clients n'utilisent pas pour réduire le coût d'ingestion, SigNoz documente les conditions du processeur de filtrage comme moyen de contrôler le volume.
Vérifier la propagation du contexte de trace. Dans le cas de LinkedIn, la cohérence d'échantillonnage entre le client et le serveur sert à ne pas casser une trace en deux. Dans un test de charge, l'injecteur joue le rôle du client. Si votre outil n'envoie pas le contexte de trace, les traces commencent chez le serveur, avec leurs propres décisions d'échantillonnage. L'inférence est de notre part : les textes ne parlent pas d'injecteurs, il faut donc la vérifier avec votre outil.
Pour les applications d'IA, un point de plus : OBI et Dynatrace savent capturer les appels aux modèles, mais OBI précise que l'extraction détaillée demande une configuration explicite de capture des charges utiles, qui n'est pas active par défaut. Regardez ce qui est réellement activé avant d'interpréter un test, et rappelez-vous que le contenu des requêtes envoyées au modèle peut contenir des données que votre environnement de test ne devrait pas conserver.
Publié par Philippe Naveau
Sources
- OpenTelemetry eBPF Instrumentation reaches v1.0.0 (blog OpenTelemetry, 30 octobre 2026), lu le
- OpenTelemetry Transformation Language reaches v1 (blog OpenTelemetry, 27 octobre 2026), lu le
- Dynatrace unifies AI Observability ingest across coding agents, OneAgent, and OpenInference (blog Dynatrace, 29 octobre 2026), lu le
- LinkedIn Uses OpenTelemetry to Trace the Member Journey from Tap to Backend (InfoQ, 3 novembre 2026), lu le