L'application est prête. Le partenaire de paiement n'ouvre son environnement de recette qu'à certaines heures, l'API du service voisin n'est pas encore livrée, et chaque appel au fournisseur de données est facturé. Les tests attendent, et le projet avec eux.
La virtualisation de services répond à ce problème depuis des années. Le temps des tests, on remplace la dépendance qui manque par un service virtuel qui répond comme elle. Ce qui a changé récemment, c'est la façon de fabriquer ces services, puisque plusieurs outils laissent désormais un assistant d'IA les créer, les régler et les arrêter. Ce guide reprend le sujet en entier pour trois lecteurs, qui n'ont pas les mêmes questions.
| Vous êtes | Votre question | Commencez par |
|---|---|---|
| Dirigeant | Qu'est-ce que ça rapporte, et quel risque je prends ? | En une page, pour décider ; Ce que ça rapporte, ce que ça coûte |
| Chef de projet | Comment je le mets en place, avec qui, dans quel ordre ? | Piloter le projet ; Choisir un outil |
| Expert technique | Comment ça marche, et jusqu'où ça va ? | Comment ça marche ; En test de performance, isoler l'application ; Industrialiser dans la chaîne CI/CD ; L'IA crée déjà des services virtuels |
En une page, pour décider
Une application dépend rarement d'elle seule. Elle appelle des partenaires, des référentiels, les services d'autres équipes. Tant que l'un d'eux manque, elle ne se teste pas, ou mal. La virtualisation de services remplace ces dépendances, dans l'environnement de test, par des services virtuels qui répondent comme elles : mêmes données, mêmes règles, mêmes temps de réponse, et les mêmes pannes quand on le demande.
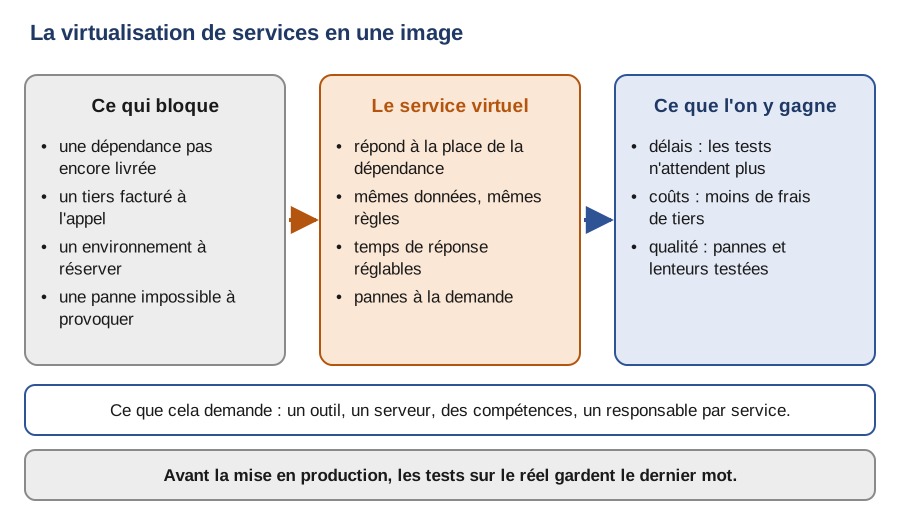
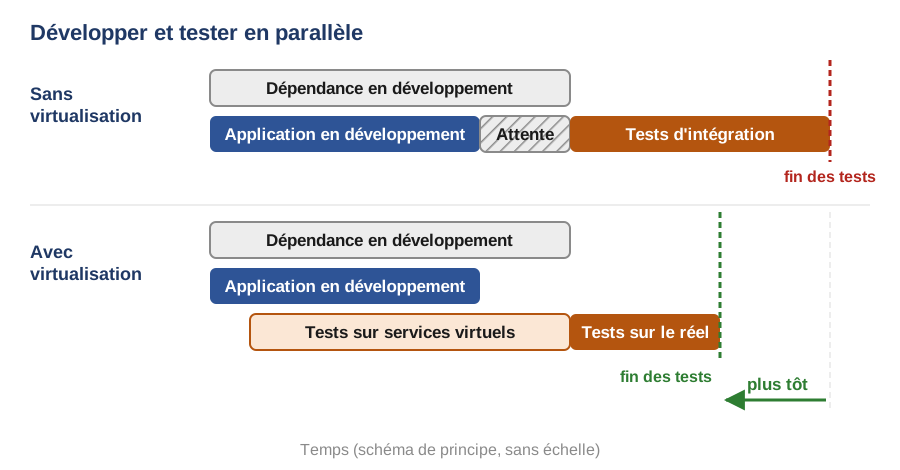
Les tests démarrent pendant le développement, puisqu'ils n'attendent plus personne, et le planning y gagne. Le budget y trouve des appels de tiers qu'on ne paie plus, et des bouchons maison qu'on cesse d'écrire puis de maintenir dans chaque équipe. La qualité, elle, gagne des tests jusque-là impossibles, comme la panne d'un partenaire, un tiers qui ralentit ou un tir de charge sur un service facturé à l'appel.
Ce n'est pas gratuit. Il faut un outil, un serveur, des compétences, et quelqu'un qui maintient chaque service virtuel quand le vrai change. Le risque principal est de croire le simulateur plus que le réel. Un service virtuel reste une hypothèse sur le comportement d'un autre système, et les tests de bout en bout sur l'environnement réel gardent le dernier mot avant la mise en production.
Toutes les dépendances ne méritent pas d'être virtualisées. Trois questions suffisent à trier, et elles se posent dépendance par dépendance.
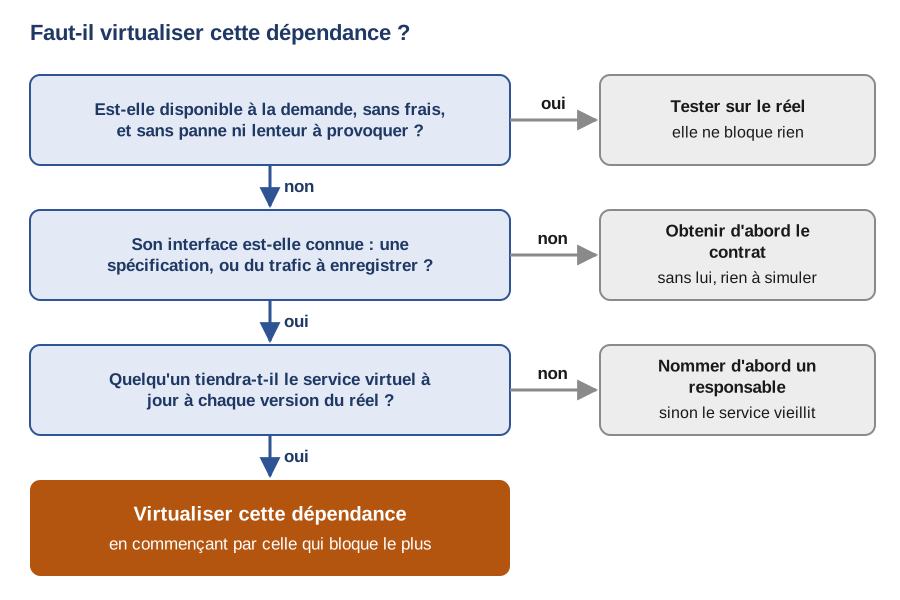
La décision à prendre tient donc en une question : quelles dépendances bloquent vos campagnes aujourd'hui, et combien vous coûte cette attente ? Si la réponse tient en un ou deux noms, commencez par ceux-là.
Le problème : des tests suspendus à leurs dépendances
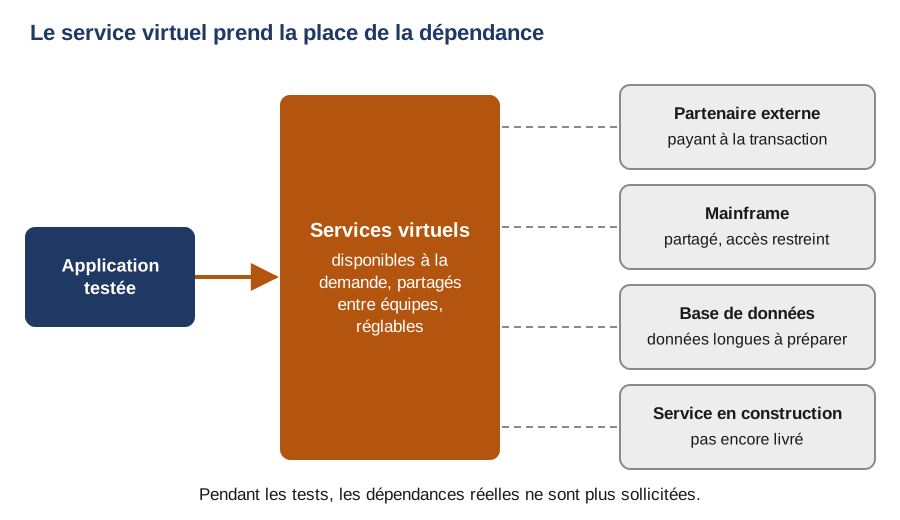
Une application appelle des partenaires externes, un mainframe partagé entre projets, une base dont les données sont longues à préparer, des services encore en construction. Chacun impose son calendrier : plages d'accès, réservation à tour de rôle, coût à la transaction, date de livraison. Le planning des tests finit par suivre celui des autres, et l'attente se paie en fin de projet, quand il reste le moins de marge.
Le service virtuel s'installe à la place de la dépendance, à l'adresse où l'application l'attend. Elle ne voit pas la différence, et c'est le but, puisqu'on teste ainsi le code qui partira en production, sans le modifier.
Le temps gagné n'est qu'une partie de l'affaire. Certaines situations ne se testent pas sur le réel, quel que soit le temps dont on dispose :
| Ce qu'on veut tester | Sur le réel | Avec un service virtuel |
|---|---|---|
| La panne d'un tiers | On ne coupe pas un partenaire pour voir | Le service passe hors ligne à la demande |
| Un tiers lent | Impossible de le ralentir sur commande | Le temps de réponse se règle |
| La montée en charge | Le tir sollicite le tiers, parfois facturé à l'appel | Le service virtuel absorbe la charge |
| Une erreur rare | Difficile à provoquer, données réelles à protéger | Les erreurs voulues, avec des données fictives |
Bouchon, mock, service virtuel : de quoi parle-t-on
Le vocabulaire s'emmêle vite, et la querelle n'est pas que de mots : selon le terme employé, on ne parle ni du même objet ni de la même équipe.
L'ISTQB, qui fait référence pour la certification des testeurs, range tous ces substituts sous le nom de « doublon de test » : un composant de substitution appelé par l'objet de test. Le bouchon y est un doublon de test qui fournit des réponses prédéfinies. La typologie de Gerard Meszaros, reprise par Martin Fowler, affine : le dummy est passé en paramètre sans jamais servir, le fake fonctionne avec un raccourci (une base en mémoire, par exemple), le stub (notre bouchon) renvoie des réponses préparées, le spy (l'espion) note en plus la façon dont on l'appelle, et le mock vérifie les appels qu'il reçoit.
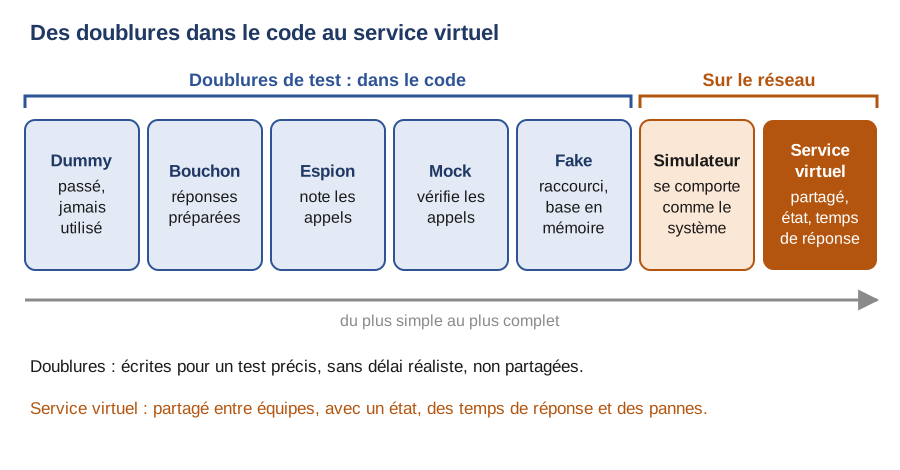
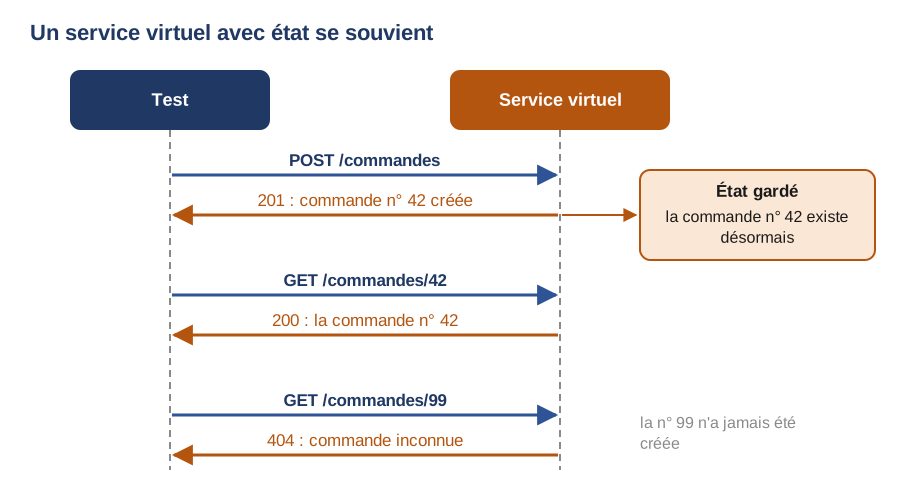
Ces doublures vivent dans le code. Le développeur les écrit pour un test précis ; elles répondent sans délai réaliste et ne servent qu'à lui. Le service virtuel se place ailleurs, sur le réseau, à l'adresse où l'application attend la vraie dépendance. Plusieurs équipes s'en servent en même temps, il se souvient de ce qu'on lui a envoyé (une commande créée réapparaît à la consultation suivante) et il reproduit les temps de réponse. Pour l'ISTQB, c'est un simulateur : un composant qui se comporte comme un composant ou un système donné.
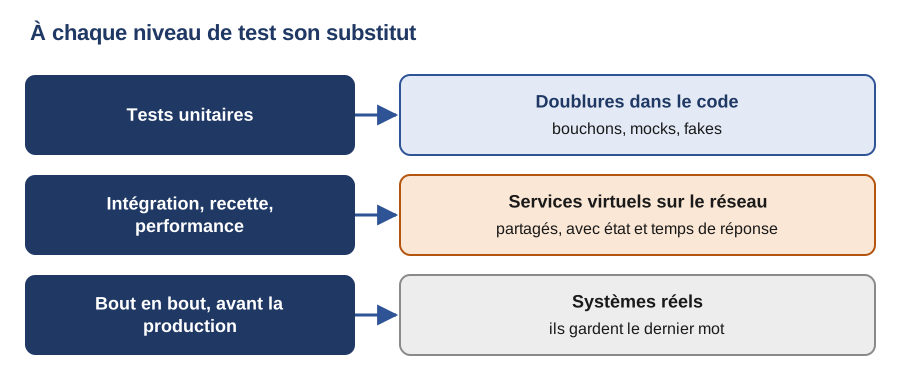
Aucun de ces substituts ne chasse les autres, chacun a son niveau de test. Les mocks gardent toute leur place au niveau unitaire, le service virtuel sert l'intégration, la recette et la performance, et les vrais systèmes reviennent pour le bout en bout.
Quant à la virtualisation de serveurs, celle des machines virtuelles, elle partage du matériel : elle n'a en commun avec notre sujet que le mot.
Comment ça marche
Enregistrer, puis rejouer
On fait passer les échanges réels par un proxy, l'outil les enregistre, puis il les rejoue sans le système réel. Le code de l'application ne change pas : seule l'adresse du service appelé pointe vers le proxy.
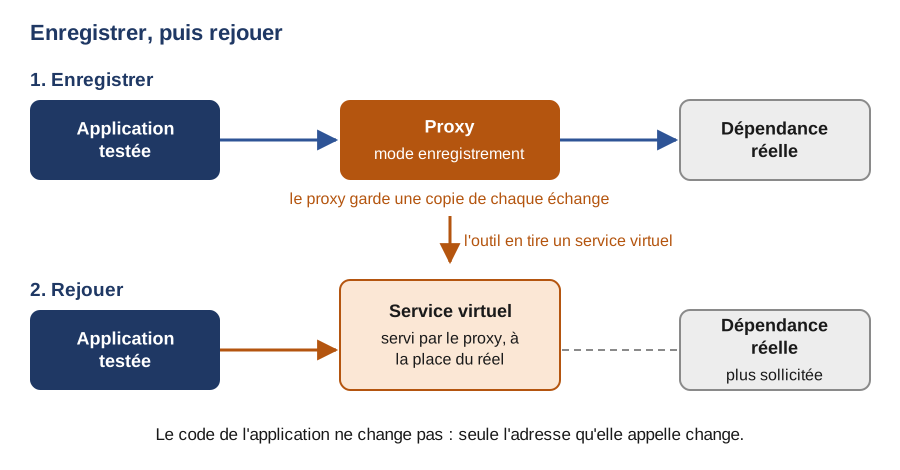
Dans le détail, la séquence compte six gestes : rediriger l'application vers le proxy, enregistrer ses échanges avec la dépendance réelle, créer le service virtuel à partir de l'enregistrement, le publier sur le serveur partagé, basculer le proxy en simulation, puis exécuter les tests sans le système réel.
Une requête que le service virtuel ne connaît pas est, au choix, transmise au système réel (le mode « passe-plat »), ignorée ou rejetée avec une erreur. Le passe-plat rend service au début, quand le service virtuel ne couvre qu'une partie des cas. Il devient un piège pendant un tir de charge, où une requête oubliée part solliciter le vrai partenaire. En HTTPS, le proxy doit présenter un certificat que l'application accepte. C'est à régler avant le premier enregistrement, pas le jour de la campagne.
L'enregistrement n'est pas le seul point de départ, et il ne peut pas l'être quand la dépendance n'existe pas encore. Une spécification OpenAPI ou WSDL suffit souvent à générer un premier service, que l'on enrichit ensuite. Le projet open source Microcks part aussi d'une spécification AsyncAPI, d'un fichier protobuf pour gRPC, d'un schéma GraphQL ou d'une collection Postman.
Tout ce qui passe sur le réseau se virtualise, mais pas avec n'importe quel outil.
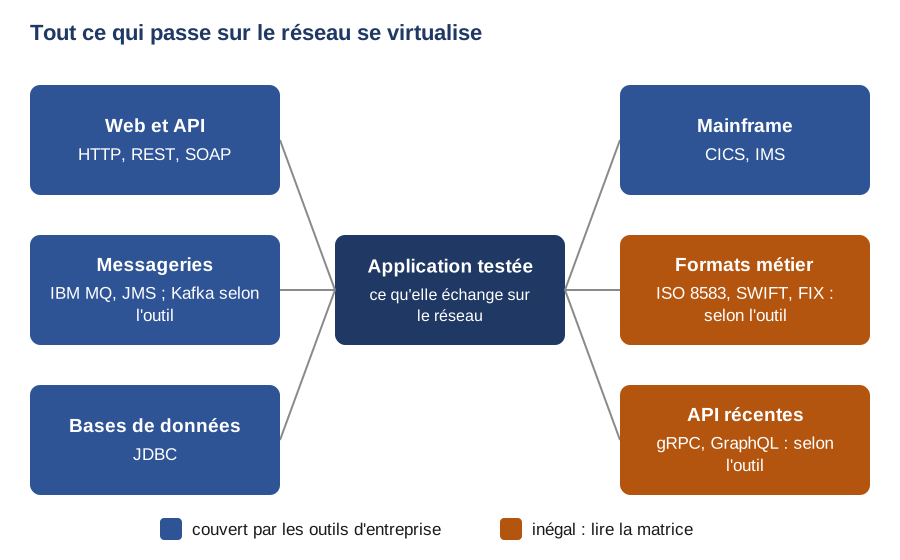
Les outils d'entreprise couvrent HTTP, les messageries, les bases de données et le mainframe, et certains les formats métier du paiement et de la finance. Kafka, gRPC et GraphQL sont couverts de façon inégale : présents chez l'un, en bêta ou absents chez l'autre. Dans la matrice d'OpenText Service Virtualization, par exemple, Kafka est en bêta dans la version 26.3, et ni gRPC ni GraphQL n'y figurent, alors que les formats ISO 8583, SWIFT et FIX y sont. Si votre système d'information repose sur l'un de ces protocoles, lisez la matrice de l'éditeur, version comprise, avant tout le reste.
L'architecture type
Les éditeurs nomment leurs composants chacun à sa façon, mais une plateforme d'entreprise se lit en quatre couches. La conception se fait sur un poste, avec un serveur embarqué pour essayer, et les projets sont versionnés dans le gestionnaire de sources. L'exécution repose sur un serveur de services virtuels, souvent en grappe, avec sa base de configuration, son API de gestion et sa console. L'accès passe par des agents : un proxy ou un écouteur par protocole (HTTP, MQ, JMS, JDBC). Restent les consommateurs : l'application testée, les outils de test et le pipeline, qui pilotent les services par l'API.
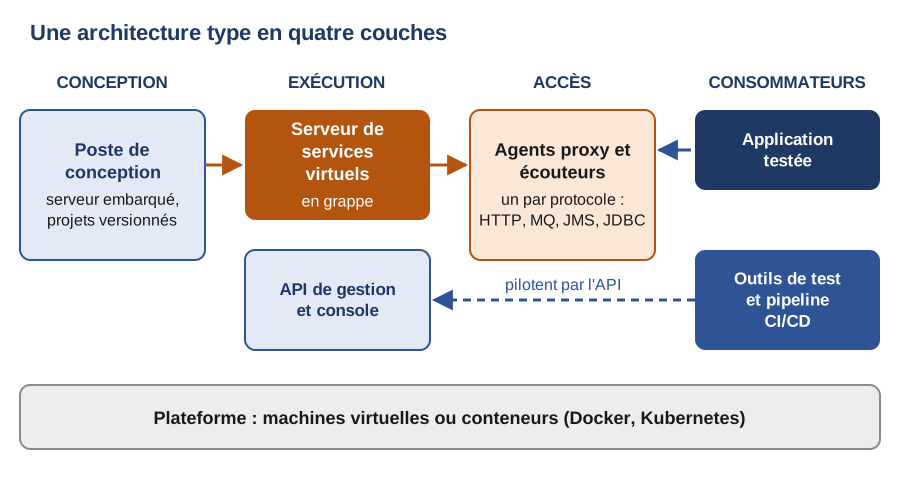
L'open source tient dans beaucoup moins : un processus ou un conteneur, une API d'administration, des fichiers de configuration dans le dépôt. Les deux mondes se rejoignent sur un point, l'API. Un service virtuel qu'on ne sait pas démarrer, régler et arrêter par programme ne s'industrialise pas.
Des réponses justes
Un service qui renvoie toujours la même réponse ne trompe aucun test. Le service virtuel choisit la sienne d'après la requête : son adresse, ses en-têtes, son contenu. Voici l'idée, en pseudo-code, pour un service de devis de livraison imaginaire :
POST /devis   { "pays": "FR", "poids_kg": 2 }

si pays = FR             -> 200  { "delai_jours": 2, "prix": 9.90 }
si pays hors zone        -> 422  { "erreur": "pays non desservi" }
si requête inconnue      -> réponse par défaut, ou passage au réel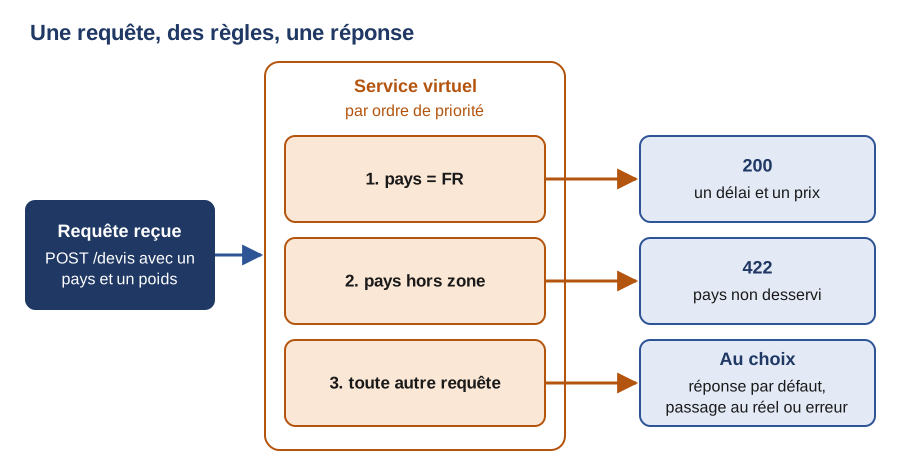
La dernière règle est celle qu'on écrit le plus vite, et à tort. Une réponse par défaut trop accommodante masque les requêtes mal formées que l'application envoie ; une erreur franche les signale.
Les données font le reste. Rejoué tel quel, un enregistrement bute sur ce qui change d'un appel à l'autre : jeton de session, horodatage, signature. Des valeurs dynamiques (dates, identifiants) règlent ce problème et évitent qu'un test rejoué bute sur un doublon. Des jeux importés d'un tableur ou d'une base couvrent les cas métier, et l'anonymisation est à faire dès l'enregistrement.
L'état donne enfin au service sa mémoire. Sans lui, la commande que le test vient de créer n'existe pas à la consultation suivante, et tout scénario de plus d'une étape tourne court.
Des réponses lentes, et des pannes
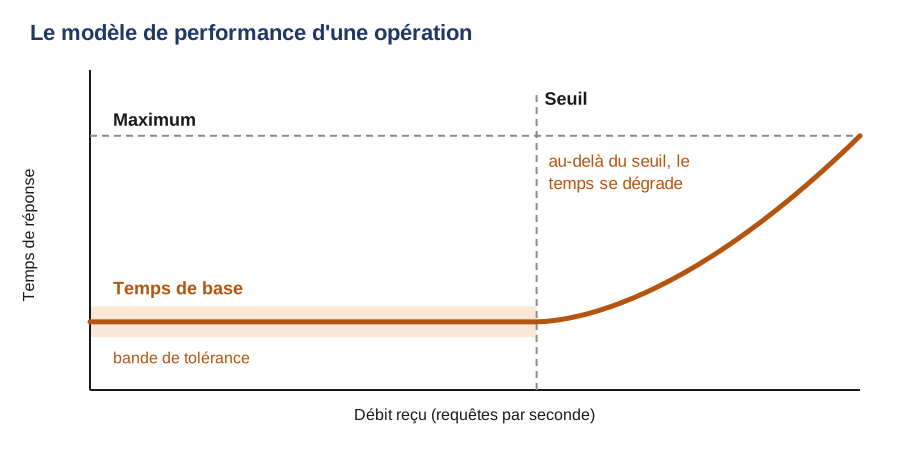
Reste le temps de réponse, qui intéresse directement les tests de performance. Les outils d'entreprise décrivent chaque opération par un modèle de performance : un temps de réponse de base, une tolérance autour de lui, un seuil de débit au-delà duquel le temps se dégrade, et un maximum.
L'open source sait le faire aussi. WireMock ajoute à une réponse un délai fixe ou aléatoire, ou l'envoie au compte-gouttes. Côté pannes, il simule une connexion réinitialisée, une réponse vide, un morceau malformé ou des données aléatoires suivies d'une fermeture. Deux bouchons suffisent à montrer le principe, l'un à délai fixe, l'autre à délai tiré au hasard entre deux bornes. Chacun est envoyé à l'API d'administration de WireMock (POST /__admin/mappings) :
{ "request":  { "method": "GET", "url": "/lent" },
  "response": { "status": 200, "body": "ok", "fixedDelayMilliseconds": 50 } }

{ "request":  { "method": "GET", "url": "/gigue" },
  "response": { "status": 200, "body": "ok",
                "delayDistribution": { "type": "uniform", "lower": 15, "upper": 25 } } }
Rejoués le 5 novembre 2026 avec WireMock 3.13.2 dans un conteneur Docker, sur 12 appels chacun (un essai de principe, pas un banc de mesure), ils ont répondu en 54,0 ms et 21,5 ms en médiane, contre 4,1 ms pour le même bouchon sans délai.
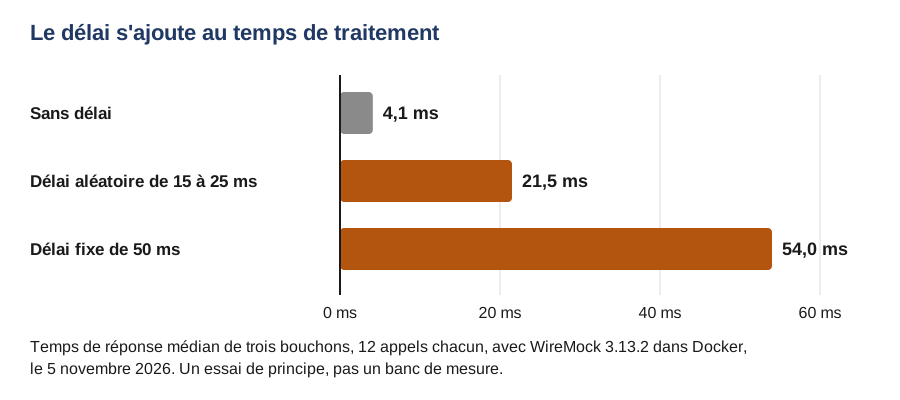
Le délai s'ajoute bien au temps de traitement : 54,0 ms pour 50 ms demandés. On prépare ainsi plusieurs comportements (nominal, dégradé, hors ligne) et chaque test choisit le sien.
En test de performance, isoler l'application
Pendant un tir, chaque appel à un tiers pose trois problèmes : on le sollicite sans qu'il l'ait prévu, on paie parfois chaque appel, et ses temps de réponse du jour faussent la mesure. Le service virtuel règle les trois d'un coup.
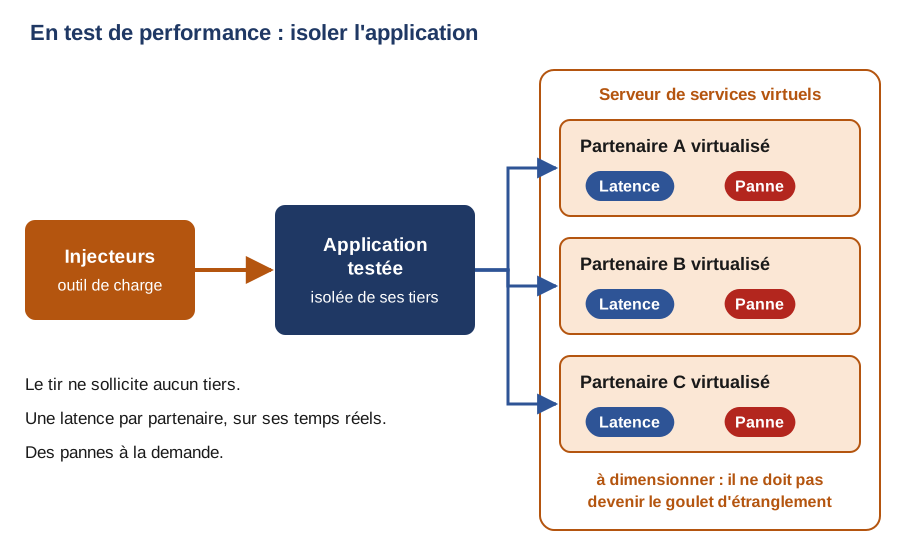
L'application testée est isolée. Chaque partenaire virtualisé reçoit sa propre latence, réglée d'après les temps observés en production, et on provoque une panne pendant le tir pour voir si l'application tient, se dégrade proprement ou s'effondre. Tous les outils ne changent pas de comportement à chaud, en cours de tir : vérifiez-le sur le vôtre avant la campagne. C'est la démarche de l'injection de pannes du chaos engineering, appliquée aux dépendances.
Mais le service virtuel est lui aussi un serveur, et s'il est sous-dimensionné, il devient le goulet d'étranglement, et le tir mesure alors le simulateur au lieu de l'application. Surveillez-le comme le reste de la plateforme (processeur, mémoire, temps de réponse servis), et faites un tir de calibrage sur le service virtuel seul avant la campagne. On monte le débit par paliers, et on note le point où le débit servi cesse de suivre le débit demandé.
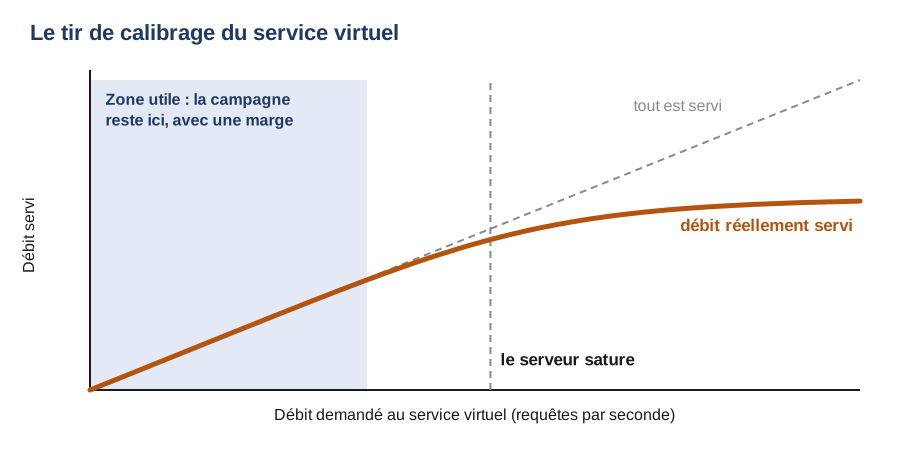
La campagne reste nettement en dessous de ce point. C'est le seul moyen de savoir quelle charge le service virtuel tient sur votre matériel. Aucun chiffre lu ailleurs ne vaut pour votre serveur, vos règles de réponse et vos volumes de données.
Un outil, cinq métiers
Le même service virtuel ne rend pas le même service à tout le monde. Le développeur code contre une API qui n'existe pas encore. L'automaticien obtient des réponses identiques à chaque exécution, si bien qu'un échec en non-régression vient de l'application et non de la dépendance. Le testeur fonctionnel déclenche l'erreur du partenaire et vérifie le message affiché. La recette métier déroule ses scénarios sans attendre les partenaires, même si la recette finale de bout en bout se fait toujours sur le réel. Le testeur de performance, lui, tire sans solliciter ni payer un tiers, et règle les latences.
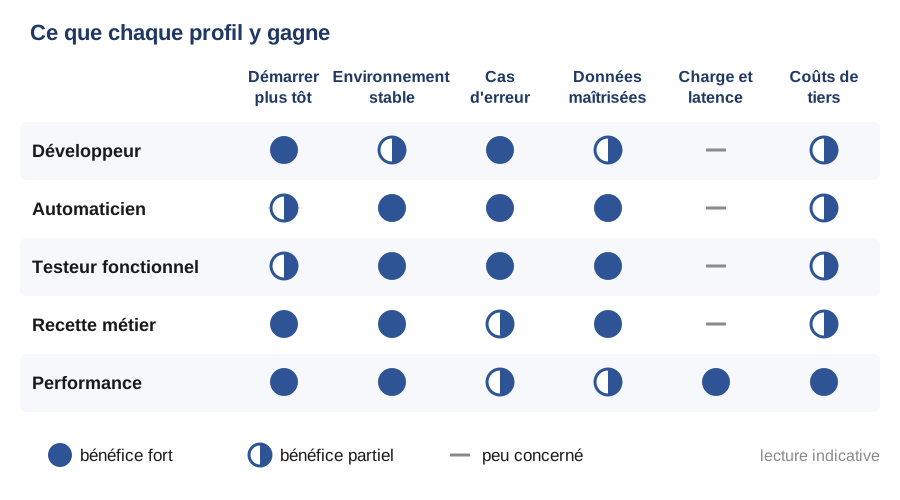
La matrice n'est pas une mesure. Elle sert à choisir par où commencer : par le profil dont les campagnes sont le plus souvent bloquées.
Industrialiser dans la chaîne CI/CD
Un service virtuel installé à la main sur un serveur finit comme les bouchons maison : plus personne ne sait qui l'a fait, ni à quelle version de l'API il correspond. La parade consiste à le traiter comme du code.
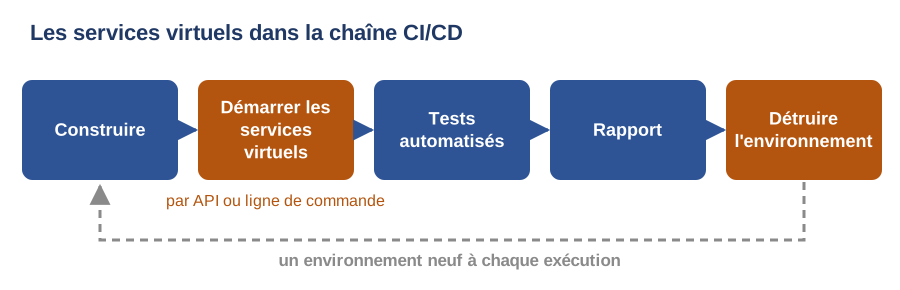
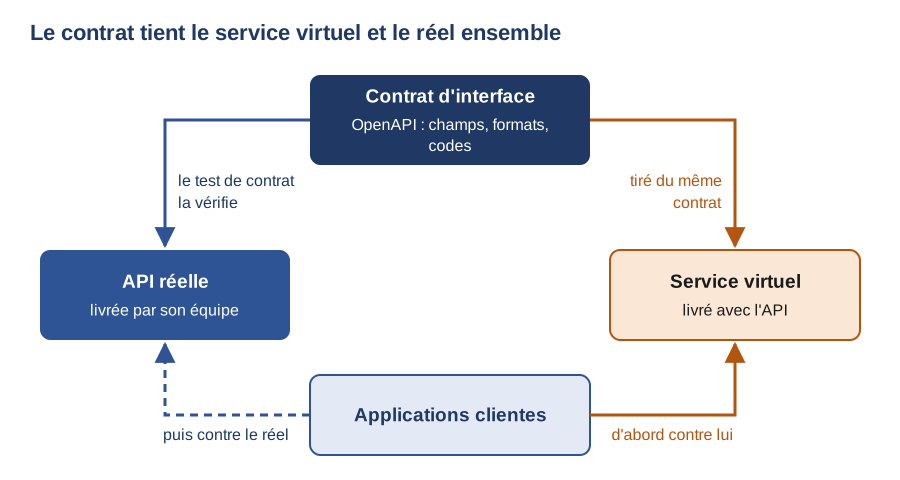
Le service virtuel vit dans le dépôt de l'API qu'il imite, et il est tiré du même contrat OpenAPI. L'équipe qui écrit l'API le livre avec elle, car c'est elle qui connaît le contrat ; les équipes qui consomment l'API testent contre ce bouchon avant la livraison, puis basculent sur le vrai service. La chaîne construit les deux, démarre le service virtuel, lance les tests contre lui, puis détruit l'environnement. Quand l'interface change, le bouchon évolue dans la même livraison ; quand seules les données changent, on met à jour son jeu de données.
Testcontainers pousse l'idée jusqu'au test lui-même : ses modules WireMock, MockServer et Microcks démarrent un service virtuel jetable depuis le code de test, et le détruisent à la fin. Pour les seuils de performance dans la chaîne, voir les tests de performance dans la CI/CD.
Le test de contrat vérifie l'autre moitié du problème : que l'API réelle et ses clients respectent la même interface (champs, formats, codes). Sans lui, rien ne dit que le bouchon ressemble encore à l'API qu'il remplace.
Or seules 17 % des organisations pratiquent le test de contrat, selon le rapport State of the API 2025 de Postman (plus de 5 700 répondants), alors que 82 % se disent « API-first » à un certain degré. L'écart dit où regarder en premier. Là où une API est simulée sans test de contrat, rien ne prévient le jour où elle change.
L'IA crée déjà des services virtuels
MCP, pour Model Context Protocol, est un standard ouvert qui relie une application d'IA à des systèmes externes : outils, sources de données. Un outil de virtualisation qui expose un serveur MCP devient pilotable par un assistant. Dans l'éditeur de code ou dans le chat, on décrit le service voulu, l'assistant le crée, le déploie, règle ses délais, puis l'arrête.
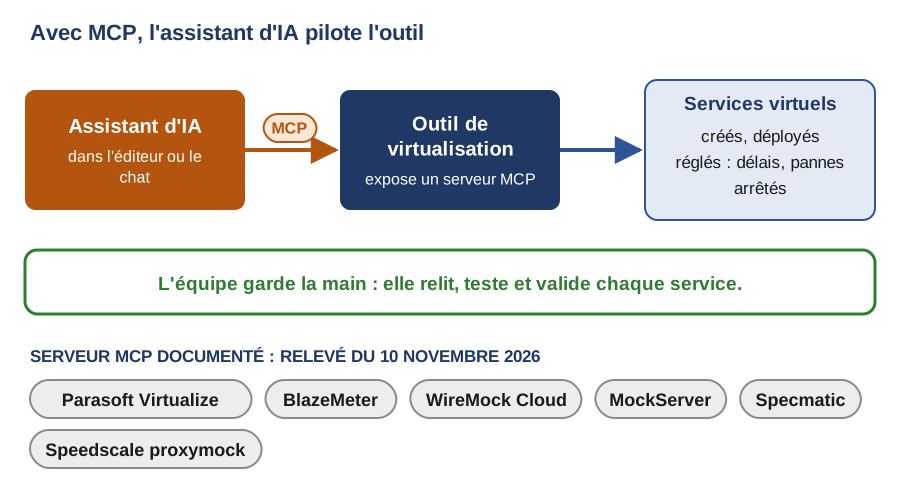
Au 10 novembre 2026, nous en avons relevé six qui documentent un tel serveur, sans prétendre à l'exhaustivité. Les noms entre parenthèses sont ceux des outils MCP que l'assistant appelle, tels que les documentations les donnent :
| Outil | Ce que l'assistant d'IA peut y faire |
|---|---|
| Parasoft Virtualize | Créer, déployer et gérer des bouchons REST depuis la version 2026.1 ; des services avec état depuis la 2026.2, sortie le 20 octobre 2026, qui déprécie l'assistant d'IA intégré, appelé à disparaître dans une version future |
| BlazeMeter Service Virtualization (Perforce) | Créer, déployer et arrêter des services virtuels, par un serveur MCP local, lancé dans Docker |
| WireMock Cloud | Créer une API simulée (create_mock_api), importer des bouchons (import_stubs_to_mock_api), en modifier un (update_stub_mapping), enregistrer du trafic (start_recording, stop_recording) |
| MockServer | Piloter l'instance par son point MCP intégré (/mockserver/mcp) ; l'outil est open source |
| Specmatic | Démarrer, arrêter et lister des serveurs de bouchons tirés d'une spécification OpenAPI (manage_mock_server), lancer des tests de contrat (run_contract_test) et de résilience (run_resiliency_test) |
| Speedscale proxymock | Enregistrer du trafic (record_traffic_start, record_traffic_stop), puis en tirer un serveur de bouchons (mock_server_start, mock_server_stop) |
Deux façons de faire se dessinent dans ce tableau. Les uns partent d'une description ou d'une spécification, les autres du trafic enregistré. Ce sont les deux points de départ vus plus haut, confiés cette fois à un assistant.
Un serveur MCP n'est pas indispensable pour autant. Un assistant d'IA peut écrire le bouchon lui-même, qu'il s'agisse d'un mapping WireMock, d'une configuration Mountebank ou d'un fichier de simulation, à condition de recevoir le bon contexte.
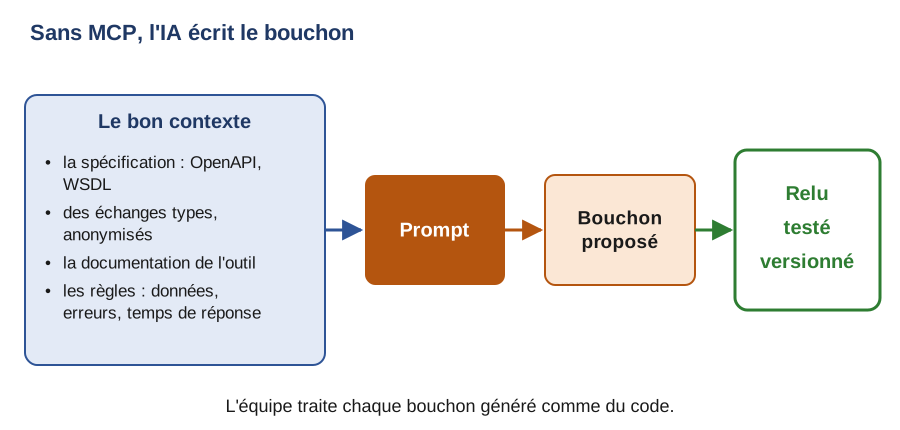
Pour le service de devis pris en exemple plus haut, la demande pourrait ressembler à ceci :
Contexte joint : la spécification OpenAPI du service de devis,
trois échanges types anonymisés, la documentation des mappings WireMock.

Écris les mappings WireMock de POST /devis :
- pays = FR        : 200, avec un délai et un prix
- pays hors zone   : 422, « pays non desservi »
- chaque réponse   : délai fixe de 50 ms
Signale ce que la spécification ne permet pas de trancher.
La dernière ligne compte autant que les autres. Un assistant comble volontiers les blancs d'une spécification ; mieux vaut qu'il les liste.
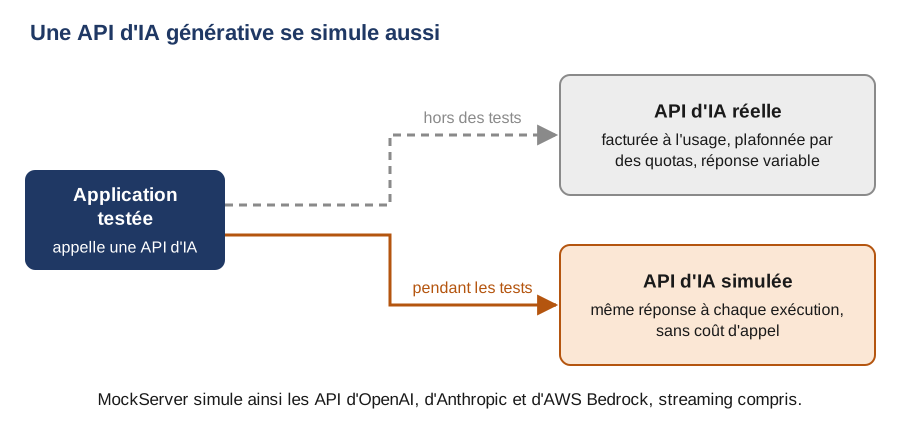
Dans l'autre sens, les applications appellent de plus en plus des API d'IA générative, qui sont des dépendances comme les autres : facturées à l'usage, plafonnées par des quotas, et dont la réponse change d'un appel à l'autre. MockServer simule celles d'OpenAI, d'Anthropic et d'AWS Bedrock, streaming compris, si bien qu'un test qui les appelle redevient reproductible, sans coût d'appel.
Microcks prend le chemin inverse : il expose ses API simulées comme des outils MCP, qu'un agent d'IA peut appeler avant que les vrais services existent. Pour l'IA dans les tests de performance eux-mêmes, voir l'IA et les tests de performance.
Deux réserves avant de s'y lancer. Les échanges enregistrés contiennent souvent des données réelles : n'en confiez à un assistant que des versions anonymisées, et seulement à un assistant validé par l'entreprise. Et la valeur d'un service virtuel tient à la justesse de ses données, de son état et de ses temps de réponse, ce qui reste un jugement humain. Aucune des pages d'éditeur lues pour ce guide ne mesure la qualité des services générés par l'IA. C'est à vous de la vérifier, service par service.
Ce que ça rapporte, ce que ça coûte
Les gains se constatent à trois endroits : dans le planning (fin de l'attente, développement et tests en parallèle), dans le budget (frais de tiers, bouchons maison, environnements mieux utilisés) et dans les anomalies trouvées (plus de cas testés, erreurs comprises, et des défauts reproduits à l'identique). Le calcul du retour sur investissement met deux colonnes face à face :
| Ce que coûte la situation actuelle | Ce que coûte la virtualisation |
|---|---|
| Les bouchons maison, écrits puis maintenus à chaque version | Les licences |
| Le temps perdu à attendre les dépendances | L'infrastructure : serveurs ou conteneurs |
| Les appels facturés par les tiers | Les compétences et la formation |
| Les tests qu'on ne fait pas, faute de pouvoir les faire | La maintenance des services virtuels |
La colonne de gauche est la plus difficile à remplir, car ses coûts sont dispersés. Les bouchons maison sont éparpillés dans les équipes, l'attente se dilue dans les plannings, et un test qu'on n'a pas fait ne laisse pas de trace. L'inventaire des bouchons maison est la ligne la plus facile à reconstituer, et il vient avant le choix de l'outil.
Méfiez-vous des pourcentages de gain qui circulent. Ceux que nous avons retrouvés sont anciens et diffusés par des éditeurs ; nous n'avons trouvé aucune étude récente et indépendante. Le seul chiffre qui vaille est celui que vous mesurerez sur vos premières dépendances virtualisées.
Choisir un outil
Le marché va du projet open source qu'on lance en une ligne de commande à la plateforme d'entreprise qui gère des dizaines d'environnements.
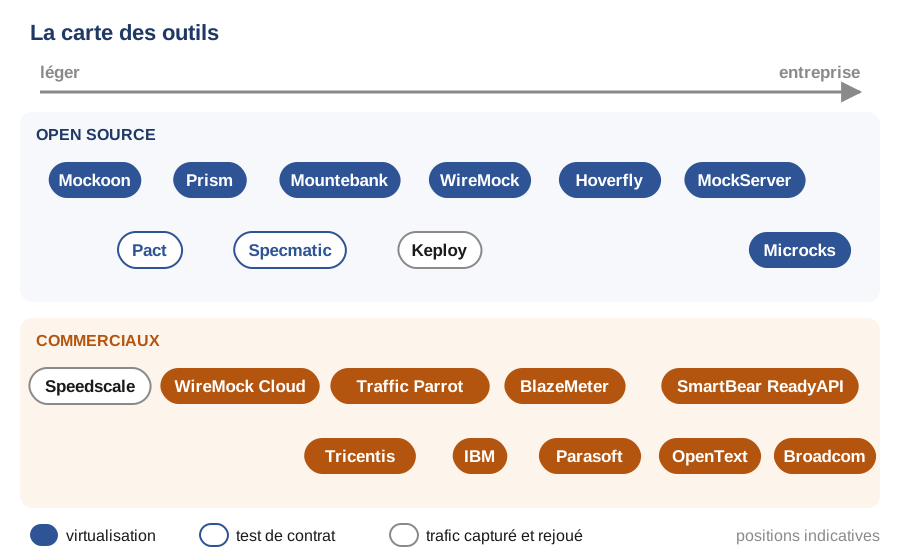
Pour HTTP et REST, l'open source suffit souvent. Au-delà (messageries, mainframe, performance à grande échelle, catalogue partagé entre équipes), les outils d'entreprise gardent l'avantage, et c'est à vérifier sur vos propres cas. Les éditeurs d'entreprise vendent le plus souvent sur devis ; plusieurs outils ont une édition gratuite ou d'essai pour démarrer.
Choisissez sur des critères, pas sur une marque. Pondérez-les selon votre contexte, puis notez chaque outil candidat sur les mêmes cas réels, ceux qui posent problème chez vous :
| Critère | Ce qu'il faut vérifier |
|---|---|
| Protocoles | La matrice de l'éditeur, version comprise : messageries, mainframe, Kafka, gRPC, GraphQL |
| Performance | Modèles de temps de réponse, tenue en charge du serveur de services virtuels |
| CI/CD et IA | API, ligne de commande, conteneurs, serveur MCP |
| Partage et gouvernance | Serveur partagé, droits, versions, catalogue des services |
| Compétences | Prise en main, formation, communauté |
| Coût total | Modèle de licence (poste, serveur, débit), abonnement, maintenance |
| Outils en place | Intégration aux outils de charge, de test et de gestion des tests déjà utilisés |
| Hébergement et sécurité | Sur site, cloud ou SaaS ; masquage des données ; certificats |
L'outil retenu est celui qui passe vos pièges : un protocole rare, un certificat capricieux, un volume de charge élevé. Une démonstration sur l'exemple de l'éditeur ne prouve rien de tout cela.
Piloter le projet
Commencez petit. Une ou deux dépendances qui bloquent vraiment suffisent : un tiers facturé à l'appel, une API qui ne sera pas livrée à temps, une panne qu'on ne peut pas provoquer sur le réel. Pour les choisir, croisez ce que chaque dépendance coûte aujourd'hui (attente, frais, tests impossibles) avec la difficulté à la simuler.
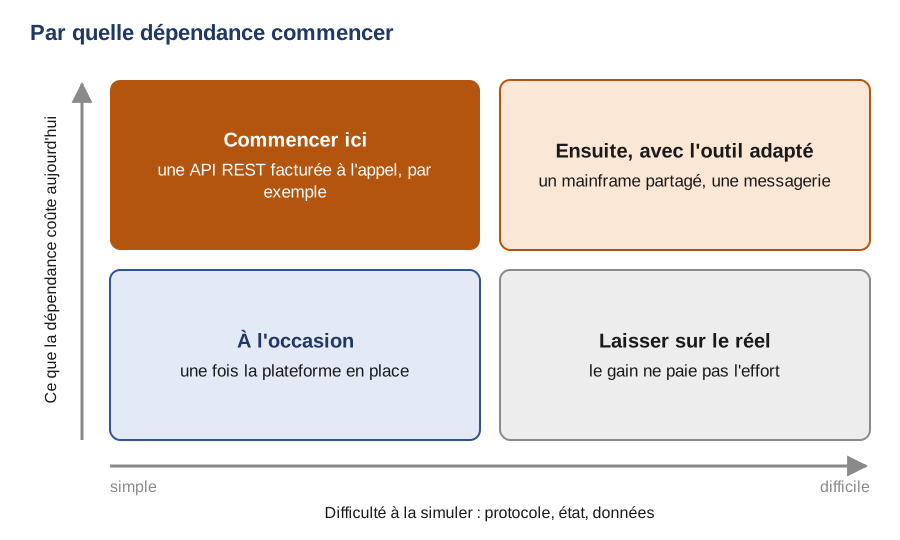
Relevez l'état de départ, puis mesurez ce que vous évitez, en jours d'attente et en frais de tiers : sans point zéro, rien à comparer. Puis étendez, et industrialisez.
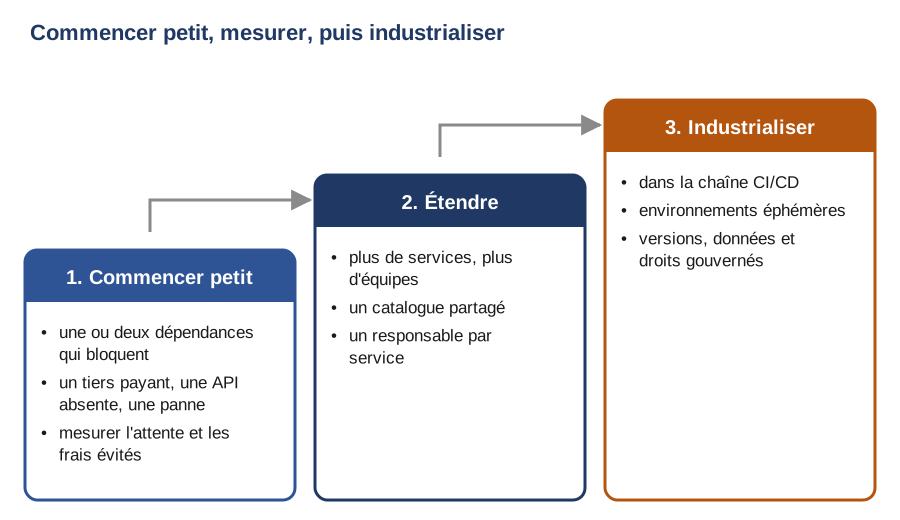
Les prérequis sont modestes mais souvent sous-estimés : les spécifications des services ou un accès aux flux réels, les ouvertures réseau et les certificats, un serveur pour les services virtuels, des données anonymisées. Les accès réseau et les certificats sont en général ce qui retarde le démarrage, bien plus que l'outil lui-même : lancez les demandes dès le premier jour. Elles ne dépendent pas de l'équipe de test : associez le réseau, la sécurité et le propriétaire de chaque service réel dès le cadrage.
Un rôle est à créer, celui de responsable de service virtuel. Chaque service a le sien, qui le met à jour à chaque version du vrai service et tient le catalogue à jour. Sans lui, les services virtuels vieillissent en silence, et les tests passent contre une API qui n'existe plus. Les autres limites ont, elles aussi, leur parade :
| Limite | Parade |
|---|---|
| Il ne remplace pas l'intégration de bout en bout | Garder des tests d'intégration système sur un environnement proche de la production |
| Il s'écarte du réel avec le temps | Le réenregistrer à chaque version du vrai service, s'appuyer sur le test de contrat |
| Tout simuler finit par tester le simulateur | Ne simuler que ce qui sort du périmètre du test, et simplement |
| L'outil demande un apprentissage | Commencer par des cas simples, former l'équipe |
| Les échanges enregistrés contiennent des données réelles | Anonymiser à l'enregistrement, préférer des données synthétiques, purger après usage |
Le premier geste ne demande aucun outil. Comptez vos bouchons maison : combien il en existe, qui les maintient, ce que chacun coûte à chaque nouvelle version de l'API qu'il imite. Ajoutez les deux dépendances qui bloquent le plus vos campagnes, et vous tenez le périmètre du premier essai.
Glossaire
| Terme | Définition |
|---|---|
| Bouchon (stub) | Doublure qui renvoie des réponses préparées à l'avance. Dans l'usage courant, tout substitut d'une dépendance. |
| Doublure de test | Composant de substitution appelé par l'objet de test ; l'ISTQB dit « doublon de test ». |
| Mock | Doublure programmée avec des attentes : elle vérifie les appels qu'elle reçoit. |
| Fake | Doublure qui fonctionne, avec un raccourci qui l'exclut de la production, comme une base en mémoire. |
| Simulateur | Composant ou système utilisé pendant les tests, qui se comporte comme un composant ou un système donné. |
| Virtualisation de services | Remplacer, en test, une dépendance par un service virtuel. L'ISTQB dit « virtualisation des services » : une technique qui fournit des services virtuels, déployés, accessibles et gérés à distance. |
| Service virtuel | Simulation partagée d'une dépendance, sur le réseau, avec son comportement fonctionnel et ses temps de réponse. |
| État | Mémoire du service virtuel d'un appel à l'autre : la commande créée se retrouve à la consultation suivante. |
| Passe-plat | Mode où une requête inconnue du service virtuel est transmise au système réel. |
| Modèle de performance | Règle du temps de réponse d'un service virtuel selon la charge : temps de base, tolérance, seuil, maximum. |
| Tir de calibrage | Tir sur le service virtuel seul, avant la campagne, pour situer le débit qu'il tient sans saturer. |
| Test de contrat | Test qui vérifie qu'une API et ses clients respectent la même interface convenue. |
| MCP | Model Context Protocol : standard ouvert qui relie une application d'IA à des systèmes externes (outils, données). |
Publié par Philippe Naveau